过去很长一段时间,国内不少运动队的竞技决策高度依赖主教练的个人经验,不少临场调整、阵容选择甚至伤病防控的判断都带着很强的主观色彩,很容易错过优化战绩的关键窗口。随着体育科技的普及,体育数据的挖掘与利用,为球队提供决策依据已经从行业前沿概念变成了多支运动队正在落地的实操方案,正在重塑整个竞技体育行业的备战逻辑。
从经验判断到数据锚定的行业转向
早年间不少基层运动队甚至顶级联赛队伍,判断运动员的疲劳程度、竞技状态几乎全靠教练组的肉眼观察和赛后的口头问询,很多隐性的身体信号很难被及时捕捉,不少运动员因此带伤训练,最终错过关键赛事的出战窗口。
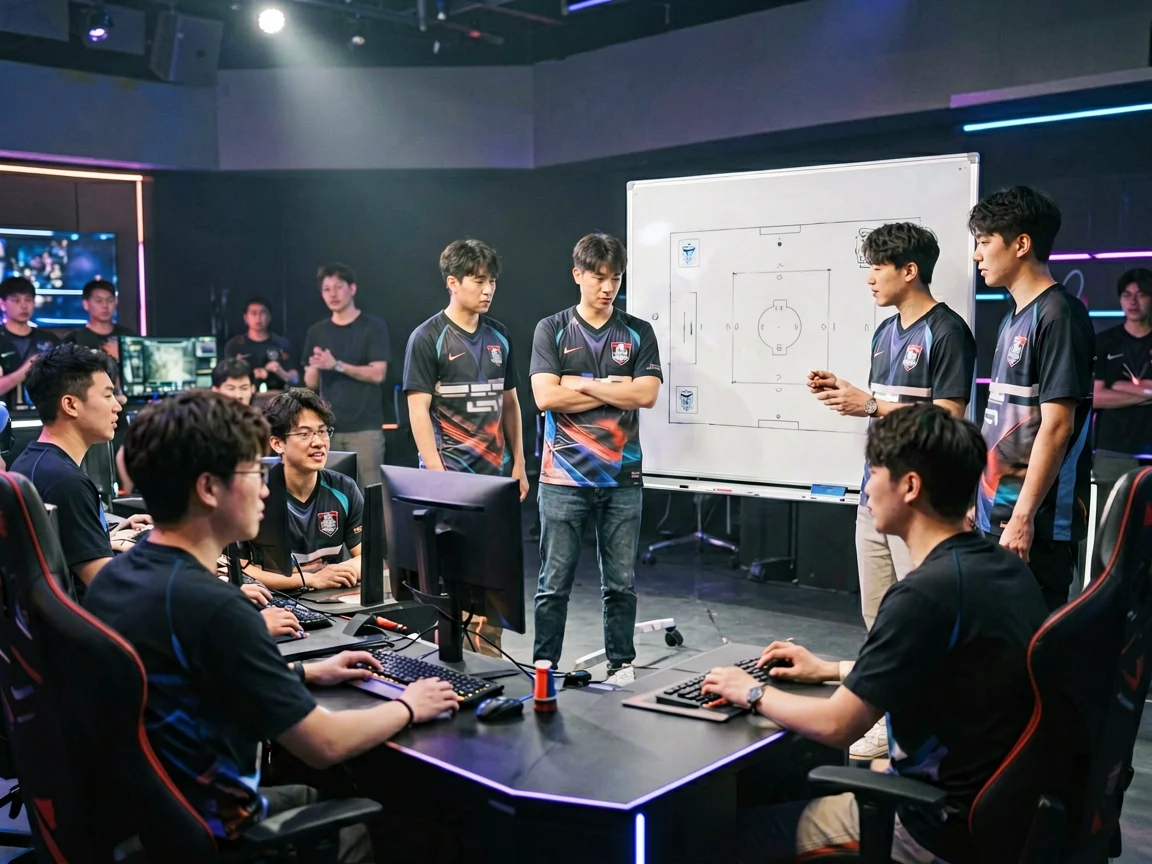
最近三年国内多支省队和职业俱乐部都搭建了专属的数据运营团队,不再只依赖公开的赛事表层统计,而是把日常训练全流程的动态数据都纳入统一采集分析体系,体育数据的挖掘与利用,为球队提供决策依据的落地场景,最先在备战周期长达数年的基础大项里跑通了完整闭环。
多维度数据交叉验证补全经验盲区
很多普通观众对体育数据的认知还停留在得分、命中率、完赛时间这类表层统计维度,实际上当前专业团队采集的数据维度已经延伸到运动员每一次动作的肌肉发力曲线、睡眠深度、日常饮食的营养摄入配比,甚至赛前一周的心理波动数值。
某支南方集体球类省队去年备战全国顶级联赛的时候,数据团队通过连续三周的赛场跑动数据比对,发现队内核心主力每次连续打满两场高强度对抗之后,第三场的变向启动速度会下降17%,这种细微的状态下滑很难被现场观赛的教练组直接捕捉到。
教练组原本的习惯是让核心主力打满绝大多数关键场次的全场,拿到数据反馈之后立刻调整了轮换节奏,把核心球员的单场出战时长控制在75%以内,同时在非关键场次安排核心球员轮休,调整之后球队后续赛事的整体胜率直接提升了22%。
这种细节层面的精准调整,没有系统化的体育数据的挖掘与利用,为球队提供决策依据的支撑,单凭教练的过往经验很难摸到准确的调整阈值,要么调整过度浪费核心球员的竞技能力,要么调整不到位起不到状态保护的作用。
数据活用要避免陷入唯数据论的误区
当前也有不少刚搭建数据团队的运动队走了弯路,熊猫体育把量化数据当成唯一的考核标准,比如硬性要求所有运动员的场均跑动距离必须达到某个固定数值,反而催生了不少无意义的无效跑动,平白浪费了运动员的体能储备。
真正成熟的数据应用逻辑,是把数据当成辅助决策的工具,而非替代教练主观判断的标准,比如不少运动员天生属于大赛型选手,平时训练的数据表现平平,但关键赛事的抗压能力和创造力远超平均水平,数据团队就需要把这类特质单独标注,纳入阵容选择的参考维度,而不是直接用日常训练数据把这类球员排除出大名单。
不少行业从业者现在也在逐步修正对数据的认知,体育数据的挖掘与利用,为球队提供决策依据的核心价值,是把原本模糊的竞技判断变得可量化、可追溯,而不是把所有和竞技相关的选择都变成冰冷的数字游戏。
后续行业落地的更多可能性
当前国内的体育数据服务还处于起步阶段,不少预算有限的中小球队没有足够成本搭建专属数据团队,只能采购第三方提供的通用数据服务,后续随着行业标准化程度提升,定制化的轻量化数据工具会逐步覆盖到更多基层运动队。
未来不管是瞄准联赛冠军的顶级职业队伍,还是扎根校园的青少年运动队,PANDASPORTS都能通过适配自身需求的数据工具,把每一份训练投入的价值最大化,让科学的竞技决策不再是资源充足的顶级强队的专属优势。